

产品信息
什么是 Vibevoice?
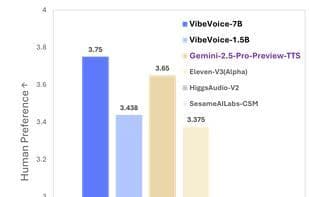
VibeVoice 是一个新颖的框架,旨在从文本中生成表现力,长形式,多扬声器对话音频(例如播客)。它解决了传统的文本到语音(TTS)系统的重大挑战,尤其是在可扩展性,扬声器一致性和自然转折方面。VibeVoice 的核心创新是其使用连续的语音令牌(原声和语义)以7.5 Hz的超低帧速率运行。这些引物器有效地保留了音频保真度,同时显着提高了处理长序列的计算效率。VibeVoice 采用了下一步的扩散框架,利用大型语言模型(LLM)了解文本上下文和对话流,以及一个扩散头来生成高效率的声学细节。
该模型可以使用多达4个不同的扬声器综合90分钟的语音,超过许多先前模型的典型1-2扬声器限制。
如何使用 Vibevoice?
VibeVoice是一个新颖的框架,旨在从文本生成富有表现力、长篇、多说话者的对话音频,例如播客,解决了传统文本转语音系统在可扩展性、说话者一致性和自然轮流对话方面的挑战。
Vibevoice 的核心功能
文字转语音,人工智能驱动
Vibevoice 的使用场景
- 从文本生成播客等长篇对话音频。
- 需要多说话者语音合成的场景。
- 合成长达90分钟的语音内容。
- 生成包含多达4个不同说话者的对话。
Vibevoice 的常见问题
VibeVoice做什么的?
我如何使用VibeVoice?
VibeVoice有哪些核心功能?
VibeVoice有哪些应用场景?